Repository navigation
[BUG] v4.2.9 升级后 SQLite 频繁 database is locked (SQLITE_BUSY),服务假死需重启(DELETE 模式数据库受影响,WAL 不受影响) #3298
Description

请确认以下事项
- 我已确认阅读并同意 AGPL-3.0 第15条 。本程序不提供任何明示或暗示的担保,使用风险由您自行承担。
- 我已确认阅读并同意 AGPL-3.0 第16条 。无论何种情况,版权持有人或其他分发者均不对使用本程序所造成的任何损失承担责任。
- 我确认我的描述清晰,语法礼貌,能帮助开发者快速定位问题,并符合社区规则。
- 我已确认阅读了OpenList文档。
- 我已确认没有重复的问题或讨论。
- 我已确认是
OpenList的问题,而不是其他原因(例如 网络 ,依赖或操作)。 - 我认为此问题必须由
OpenList处理,而非第三方。 - 我已确认这个问题在最新版本中没有被修复。
- 我没有阅读这个清单,只是闭眼选中了所有的复选框,请关闭这个 Issue 。
OpenList 版本(必填)
v4.2.9
使用的存储驱动(必填)
115网盘、本机存储(Local)。问题发生在 SQLite 数据库层,与存储驱动无关。
问题描述(必填)
现象
4 台设备的 OpenList 于 2026-10-25 / 10-26 由 WatchTower 自动升级到 v4.2.9 后,开始频繁假死:
- 网页无法登录、WebDAV 请求无响应;假死期间每个请求固定耗时约 5 秒(对应 busy_timeout=5000ms)后报错
- 日志中出现大量
database is locked (5) (SQLITE_BUSY) - 唯一恢复方式是重启进程/容器,重启后立刻恢复 20ms 内响应
根因分析(用户侧排查结论)
受影响设备的数据库文件是早期版本创建的,journal_mode 为 DELETE(SQLite 文件头 offset 18-19 字节为 01 01)。DELETE 模式下写事务与读请求互斥,v4.2.9 的后台写事务一旦持锁,所有读请求需等待 busy_timeout(5s) 后报 SQLITE_BUSY,请求堆积导致服务假死。
对照组:另一台设备同样运行 v4.2.9,但数据库文件创建时即为 WAL 模式(文件头 02 02)→ 全程 0 次 SQLITE_BUSY,运行正常。
用户侧将 DELETE 模式数据库手动执行 PRAGMA journal_mode=WAL; 后,假死问题消失。
建议修复方向
建库时初始化 PRAGMA journal_mode=WAL,或启动时检测 journal_mode 非 WAL 的旧库并自动迁移(旧版本创建的库不会随版本升级改变 journal mode)。
日志(必填)
原始日志(SQLITE_BUSY 报错样例)
ERRO[2026-10-27 00:21:19] PROPFIND /dav/115/ database is locked (5) (SQLITE_BUSY)
ERRO[2026-10-27 00:21:24] PROPFIND /dav/115/云下载/ database is locked (5) (SQLITE_BUSY)
ERRO[2026-10-27 00:21:29] PROPFIND /dav/ database is locked (5) (SQLITE_BUSY)
ERRO[2026-10-27 00:21:34] PROPFIND /dav/115/ database is locked (5) (SQLITE_BUSY)
ERRO[2026-10-27 00:21:39] PROPFIND /dav/115/云下载 database is locked (5) (SQLITE_BUSY)
时间分布(同机不同时期日志文件统计)
| 日志文件 | 时期 | SQLITE_BUSY 次数 |
|---|---|---|
| log-2026-09-29*.log(3 个文件) | 旧版本 | 0 |
| log-2026-10-07*.log | 旧版本 | 0 |
| log-2026-10-21*.log | 旧版本 | 0 |
| log.log(10-26 升级 v4.2.9 后) | v4.2.9 | 330 |
配置文件内容(必填)
{
  "force": false,
  "site_url": "",
  "cdn": "",
  "jwt_secret": "********",
  "token_expires_in": 48,
  "database": {
    "type": "sqlite3",
    "host": "",
    "port": 0,
    "user": "",
    "password": "",
    "name": "",
    "db_file": "data/data.db",
    "table_prefix": "x_",
    "ssl_mode": "",
    "dsn": ""
  },
  "scheme": {
    "address": "0.0.0.0",
    "http_port": 5244,
    "https_port": -1
  },
  "temp_dir": "data/temp",
  "bleve_dir": "data/bleve",
  "log": {
    "enable": true,
    "name": "data/log/log.log",
    "max_size": 50,
    "max_backups": 30,
    "max_age": 28,
    "compress": false,
    "filter": {
      "enable": false,
      "filters": []
    }
  },
  "delayed_start": 0,
  "auto_memory_limit": 4,
  "min_free_memory": 0,
  "max_block_limit": 0,
  "max_connections": 0,
  "max_concurrency": 64,
  "tls_insecure_skip_verify": false,
  "tasks": {
    "download": { "workers": 5, "max_retry": 1, "task_persistant": false },
    "transfer": { "workers": 5, "max_retry": 2, "task_persistant": false },
    "upload": { "workers": 5, "max_retry": 0, "task_persistant": false },
    "copy": { "workers": 5, "max_retry": 2, "task_persistant": false },
    "move": { "workers": 5, "max_retry": 2, "task_persistant": false },
    "decompress": { "workers": 5, "max_retry": 2, "task_persistant": false },
    "decompress_upload": { "workers": 5, "max_retry": 2, "task_persistant": false },
    "allow_retry_canceled": false
  },
  "s3": { "enable": false },
  "ftp": { "enable": false },
  "sftp": { "enable": false },
  "mcp": { "enable": false },
  "last_launched_version": "v4.2.9"
}
(省略了 cors / ftp / sftp 等保持默认的字段,其余内容未改动;jwt_secret 已脱敏)
AI生成内容
- 我使用了AI工具生成此内容
- 我没有使用AI工具生成此内容
AI模型是
GLM-5.3-Flash
Activity
Alien-Et commentedon Oct 27, 2026
问题➕1。我也遇到这个问题,我准备提issue时看到了你的提问。那我就在评论区做补充吧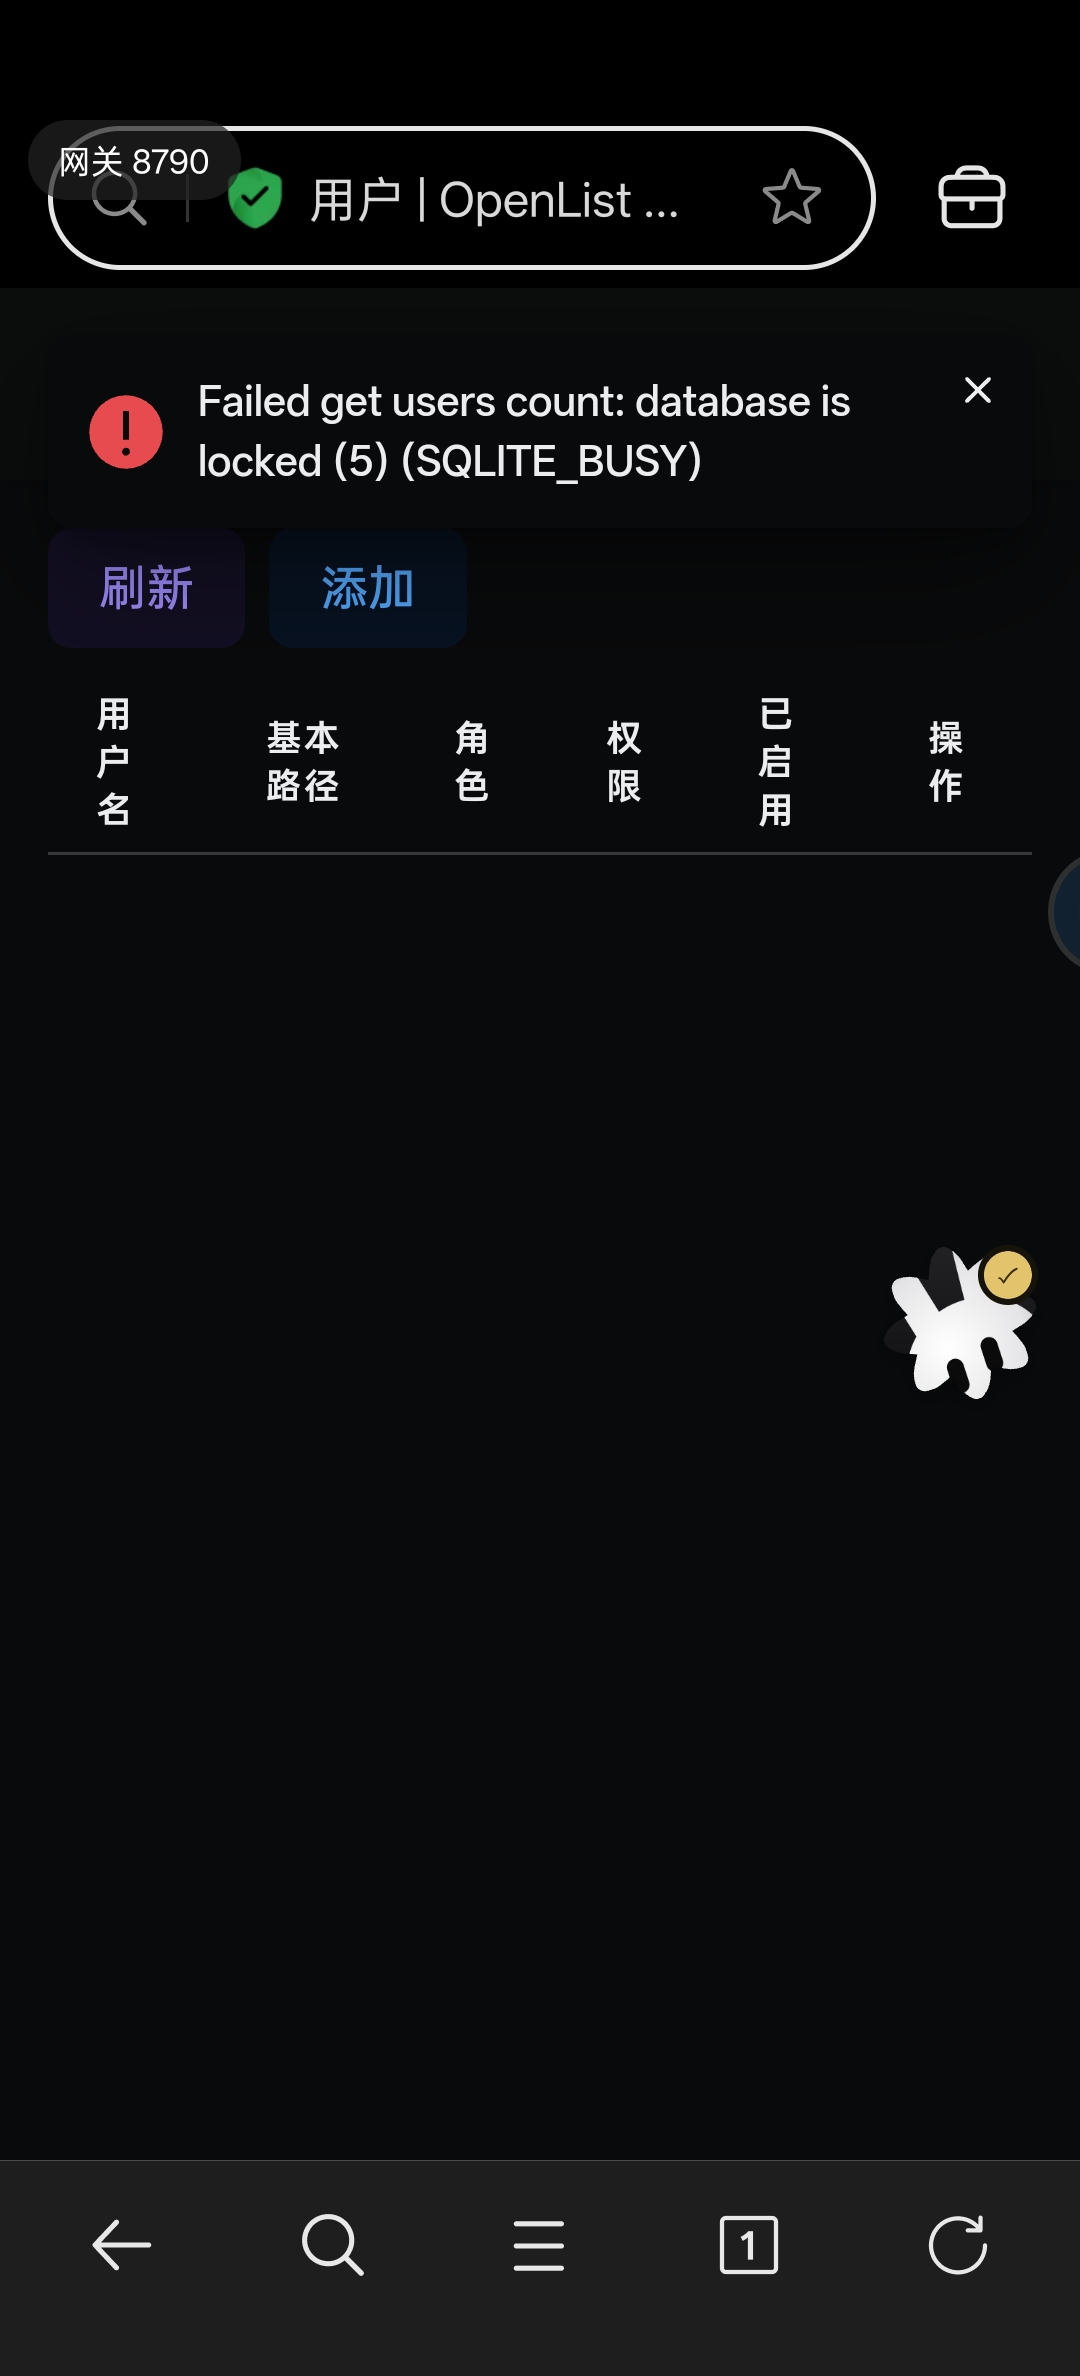
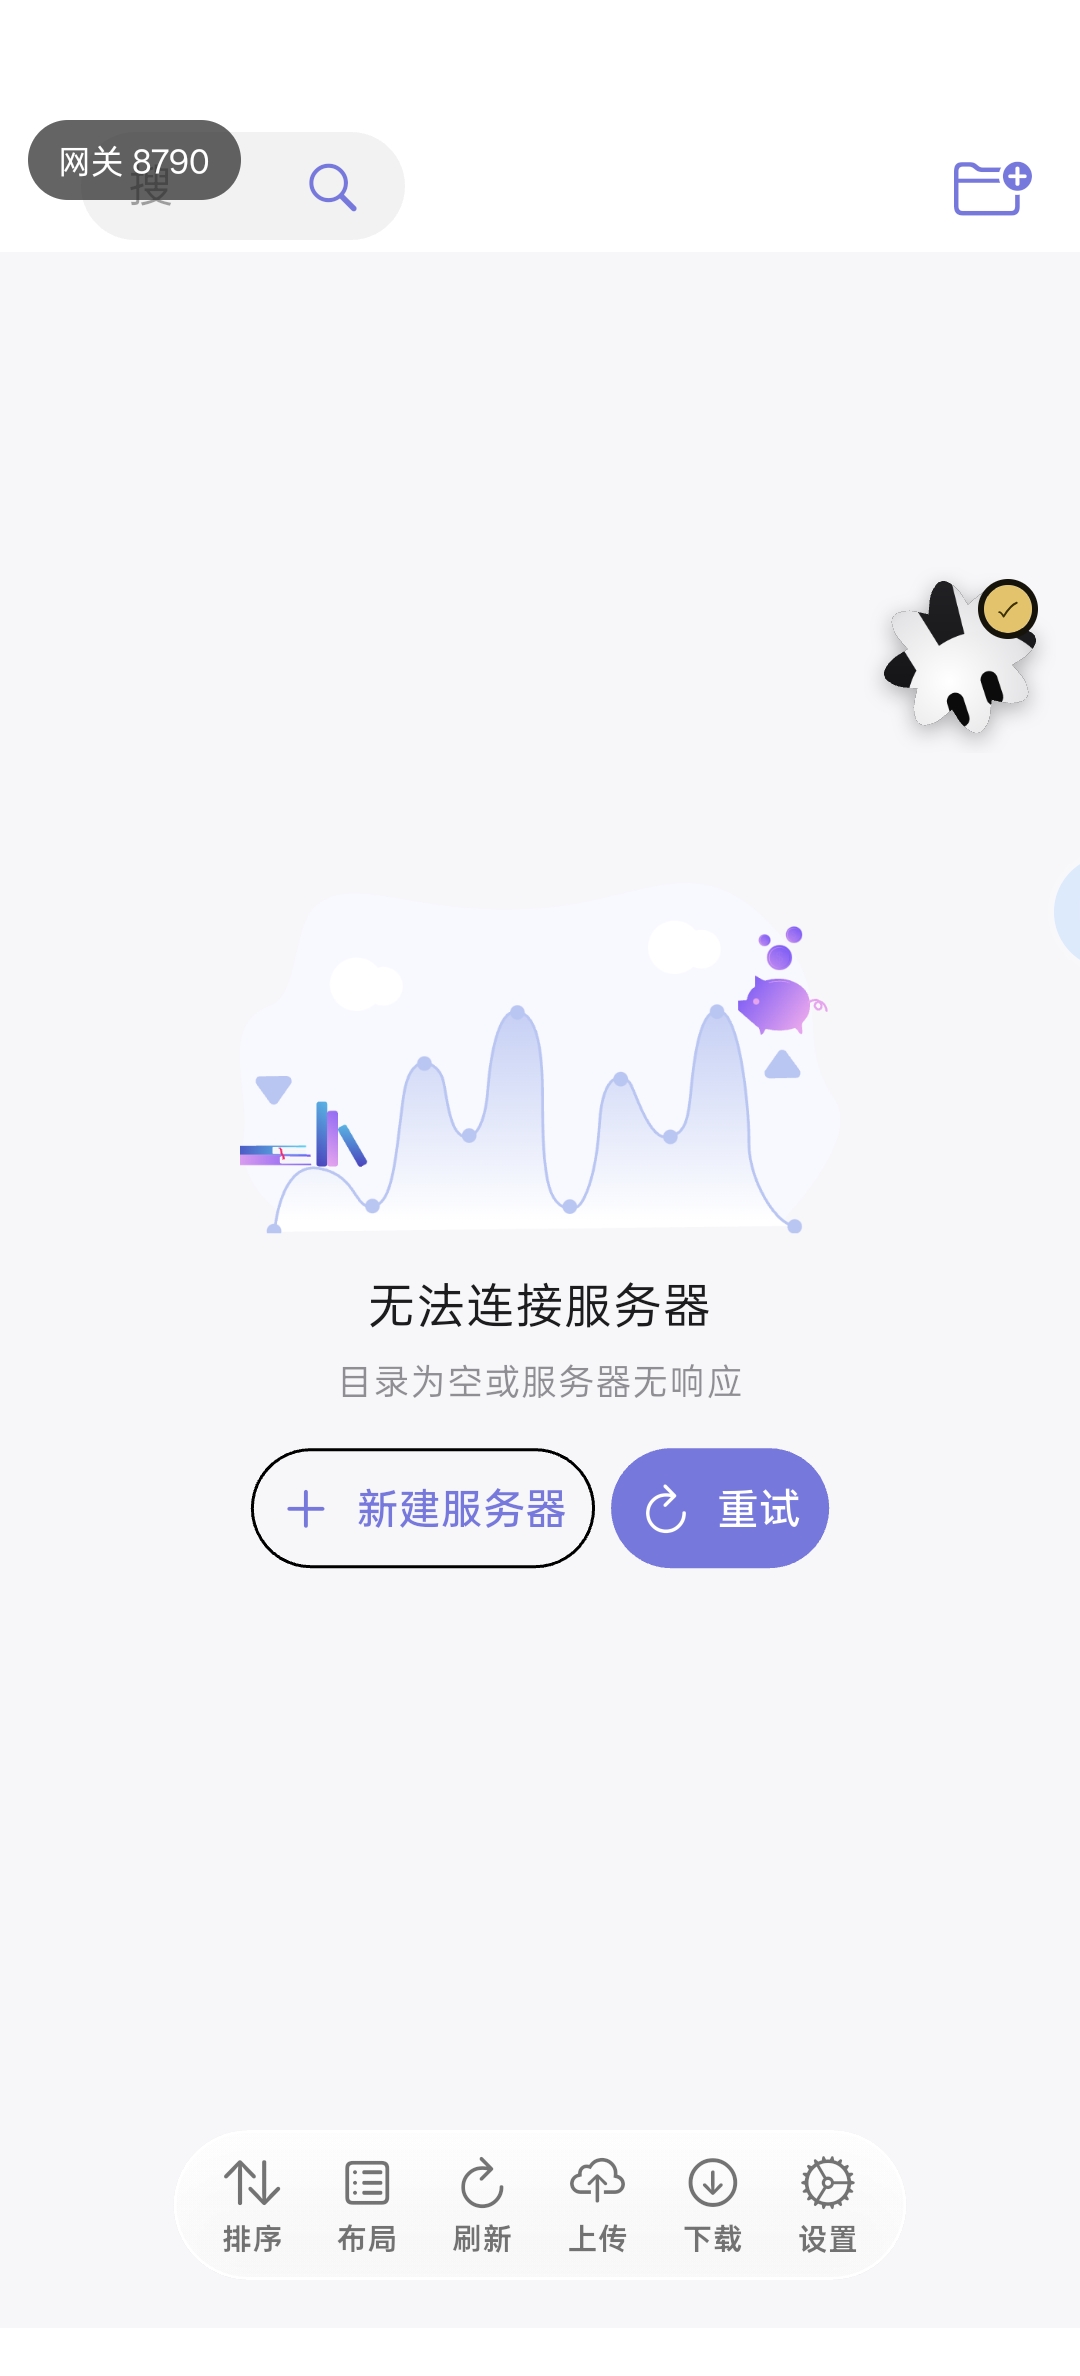
在我使用第三方webdav客户端在做索引扫描时,openlist数据库直接给我干崩了,网页可以访问,但是点击图一用户那就提示数据库有问题。webdav客户端直接访问失败!!
88m commentedon Oct 28, 2026
同样遇到这个问题。webdav一段时间不用 直接连不上,重启后又能用。webdav连不上的时候,网页一切正常,docker日志无异常。
openlist自己的日志里面有错误:
ERRO[2026-10-28 12:15:08] PROPFIND /dav/139/ SQL logic error: cannot start a transaction within a transaction (1)
[GIN] 2026/10/28 - 12:15:08 | 500 | 904.339µs | 192.168.2.226 | PROPFIND "/dav/139/"
ERRO[2026-10-28 12:15:10] PROPFIND /dav/ SQL logic error: cannot start a transaction within a transaction (1)
[GIN] 2026/10/28 - 12:15:10 | 500 | 539.337µs | 192.168.2.226 | PROPFIND "/dav/"
ERRO[2026-10-28 12:15:17] PROPFIND /dav/ database is locked (5) (SQLITE_BUSY)
[GIN] 2026/10/28 - 12:15:17 | 500 | 5.02s | 192.168.2.226 | PROPFIND "/dav/"
ERRO[2026-10-28 12:15:22] PROPFIND /dav/ database is locked (5) (SQLITE_BUSY)
[GIN] 2026/10/28 - 12:15:22 | 500 | 5.01s | 192.168.2.226 | PROPFIND "/dav/"
grock304 commentedon Oct 29, 2026
同样问题,也是升级 v4.2.9 后出现的,但退回 v4.2.8 问题依旧
dingxy1996 commentedon Oct 29, 2026
同样存在这个问题,使用dav会出现,重启openlist即可解决,但运行一段时间后再次出现
voncamel commentedon Oct 31, 2026
补充排查与根因分析:为什么强切 WAL 只是掩盖症状?真正的 Regression 在事务生命周期
看到大家都在讨论 PRAGMA journal_mode=WAL;,这里补充一些底层代码排查视角的分析,供作者和各位参考:
为什么此前版本默认 DELETE 模式没有大面积暴雷?
SQLite 默认保持 DELETE 模式通常是为了保证最大的环境兼容性。很多用户的 Docker data 目录是挂载在 NFS、CIFS/SMB、SSHFS 或 FUSE 网络存储上的。WAL 模式强依赖宿主机的 POSIX 共享内存(-shm 与 mmap),在网络文件系统上直接开 WAL 极易报 disk I/O error 甚至直接无法建库。因此保持 DELETE 模式本身是一套防御性兼容设计,并非单纯的配置遗漏。
v4.2.9 真正的 Regression(回归缺陷)在哪里?
在 DELETE 模式下,读写互斥是正常的,只要事务能在几毫秒内提交释放,高频并发最多稍微排队,绝不至于全服务假死。
从楼上 @88m 贴出的关键日志可以明确看到:
ERRO[...] PROPFIND /dav/... SQL logic error: cannot start a transaction within a transaction (1)
ERRO[...] PROPFIND /dav/... database is locked (5) (SQLITE_BUSY)
这表明 v4.2.9 的核心问题并非“没有开 WAL”,而是 WebDAV / PROPFIND 相关链路的代码出现了事务管理漏洞:
嵌套事务与未释放连接:在某个处理流程中(例如访问审计、Token 刷新或元数据缓存写操作),代码在未提交/未回滚现有事务的前提下再次开启了新事务;
事务泄露导致排他写锁常驻:因为抛出了 cannot start a transaction within a transaction 或在异常分支遗漏了 tx.Rollback() / tx.Commit(),导致该数据库连接的排他锁(Exclusive Lock)被永久持有;
级联超时崩溃:后续所有无论是来自 Kodi、RaiDrive 还是 Web 前端的读写请求,都会卡满 SQLite 的 busy_timeout(5000ms),进而打满 Gin/Goroutine 工作队列,最终造成服务整体假死。
WAL 模式的核心特性是读写并发不互斥。将数据库切为 WAL 模式后,读操作不再被那个“未释放/泄露的写事务”所阻塞,所以 Web 访问和 WebDAV 浏览恢复了响应。但这只是掩盖了读阻塞的表象,并没有解决写连接泄漏的根本问题。
建议作者排查方向:
重点审查 v4.2.8 -> v4.2.9 中涉及 WebDAV 处理逻辑(尤其是 PROPFIND 处理链、审计日志写入或存储缓存更新)的数据库事务包裹代码;
排查是否存在没有 defer tx.Rollback()、异常分支提早 return 导致事务未完结、或者在已有事务上下文的函数中再次调用了 db.Begin() 的情况;
对于确实运行在本地文件系统(ext4/xfs/NTFS)的用户,可在初始化时判断文件系统类型后推荐或自动迁移到 WAL,但根本上仍需先修复事务嵌套与泄露的 Bug。
BLACK-BIRTHDAY commentedon Nov 6, 2026
已定位到 v4.2.8 / v4.2.9 触发
cannot start a transaction within a transaction (1)与database is locked (5) (SQLITE_BUSY)永久假死的 3 处具体源码原因,并已提交修复 PR #3342 :PROPFIND被withDeadPropsTransaction长事务包裹(server/webdav/webdav.go:910):fix(webdav)!: correct COPY/MOVE semantics, dead property persistence, and lock enforcement #3210 在
handlePropfind中使用withDeadPropsTransaction开启事务(BEGIN+SELECT 1)并包裹了整个walkFS远端网盘目录遍历(耗时可达数秒至十余秒),同时walkFS内部又通过全局连接池调用op.GetNearestMeta->db.GetMetaByPath申请第二个连接,导致单次PROPFIND长时间持有 SQLite 锁并阻塞写事务提交。withDeadPropsTransaction在ctx取消或Commit失败时污染连接池(server/webdav/prop.go:334):database.WithContext(ctx).Transaction(...)在请求上下文ctx超时/取消或Commit()因SQLITE_BUSY失败时,database/sql会先将sql.Tx标记为done=1(导致外层第 343 行的transaction.Rollback()直接返回sql.ErrTxDone成为空操作),并将底层仍处于未提交事务状态的*sqlite.conn直接归还到sql.DB空闲连接池。此后:SQL logic error: cannot start a transaction within a transaction (1);database is locked (5) (SQLITE_BUSY),直至重启进程。glebarez/sqlite未转换_journal=WAL参数(internal/bootstrap/sqlite_driver_glebarez.go):internal/bootstrap/db.go传入的?_journal=WAL&_vacuum=incremental是 CGO 驱动mattn/go-sqlite3的参数名,切换至github.com/glebarez/sqlite(modernc.org/sqlite)后驱动仅识别_pragma=journal_mode(WAL)与_txlock=immediate,导致未手动转换过的数据库一直运行在DELETE回滚日志模式(文件头01 01)。详情与回归测试见 PR #3342 。
Zhuoershang commentedon Nov 6, 2026
同出现这个问题 折腾死了
sghng commentedon Nov 9, 2026
I reproduced the same transaction-poisoning sequence on v4.2.9 (
0497ee8), running rootless Podman with the SQLite DB on local NVMe inDELETEjournal mode. The storage backend was Quark, and the trigger was sustained WebDAV traffic from Restic through RClone.The log sequence matches the diagnosis in #3342:
Once this happened,
lslocksshowed OpenList itself holding a POSIXWRITElock, and subsequentPROPFINDrequests returned HTTP 500 until the process was restarted.PRAGMA integrity_checkreturnedokafter restart.One additional stress case: with RClone
--vfs-cache-mode off, Restic's temporary-file → content-hash renames also failed asCouldn't move: copy call failed: Internal Server Error; a later retry hit HTTP 409. A cache-full Restic run had completed successfully previously. The rename failures may be downstream of the same lock rather than an independent bug, but this workload looks useful for exercising the failure path.